

Pubblicato il
Alle 8:17 il gestionale non rispondeva più, il sito e-commerce restituiva errore 500 e sul server arrivavano I/O wait anomali. Un caso reale recupero dati server non inizia quasi mai con una schermata drammatica: parte con sintomi piccoli, intermittenti, spesso sottovalutati fino a quando il servizio si ferma davvero.
In questo scenario parliamo di una PMI con un unico server dedicato usato per database, file applicativi e macchine virtuali leggere. Un’impostazione ancora comune in molte aziende italiane: comoda da gestire, costi prevedibili, ma anche un punto singolo di rischio quando storage, backup e monitoraggio non sono progettati con sufficiente margine.
Il contesto del guasto
L’infrastruttura era basata su un server con controller RAID hardware e quattro dischi SSD in RAID 10. La configurazione, sulla carta, era corretta per un carico misto tra database MySQL, documentale interno e sito aziendale ad alto traffico stagionale. Il problema non era la sola scelta della macchina, ma l’insieme delle dipendenze costruite sopra quel nodo.
Nei giorni precedenti all’incidente erano già comparsi segnali chiari: latenze in scrittura, alert SMART non letti in tempo, incremento del tempo di rebuild e snapshot di backup notturne più lente del normale. Nessun allarme aveva causato fermo immediato, quindi l’operatività era proseguita. È qui che molti casi di recupero dati diventano critici: il degrado viene interpretato come un rallentamento temporaneo, non come l’anticamera di un fault serio.
La mattina del blocco, due SSD risultavano in stato incoerente e il controller RAID riportava volumi degradati con errori di lettura non correggibili. Il filesystem montava in sola lettura in modo intermittente. Dopo il riavvio, il sistema non riusciva più a portare online tutti i servizi applicativi.
Caso reale recupero dati server: il primo errore da evitare
Quando un server non parte o monta volumi danneggiati, la reazione più comune è tentare più riavvii, forzare check automatici o lanciare utility di ricostruzione senza una fotografia precisa dello stato dei dischi. In questo caso il team interno ha fatto bene a fermarsi quasi subito.
La regola operativa è semplice: prima si mette in sicurezza, poi si tenta il ripristino. Ogni scrittura non controllata può peggiorare la corruzione logica o rendere più complessa la ricostruzione del RAID. Il recovery non è solo una questione tecnica, è una questione di sequenza corretta.
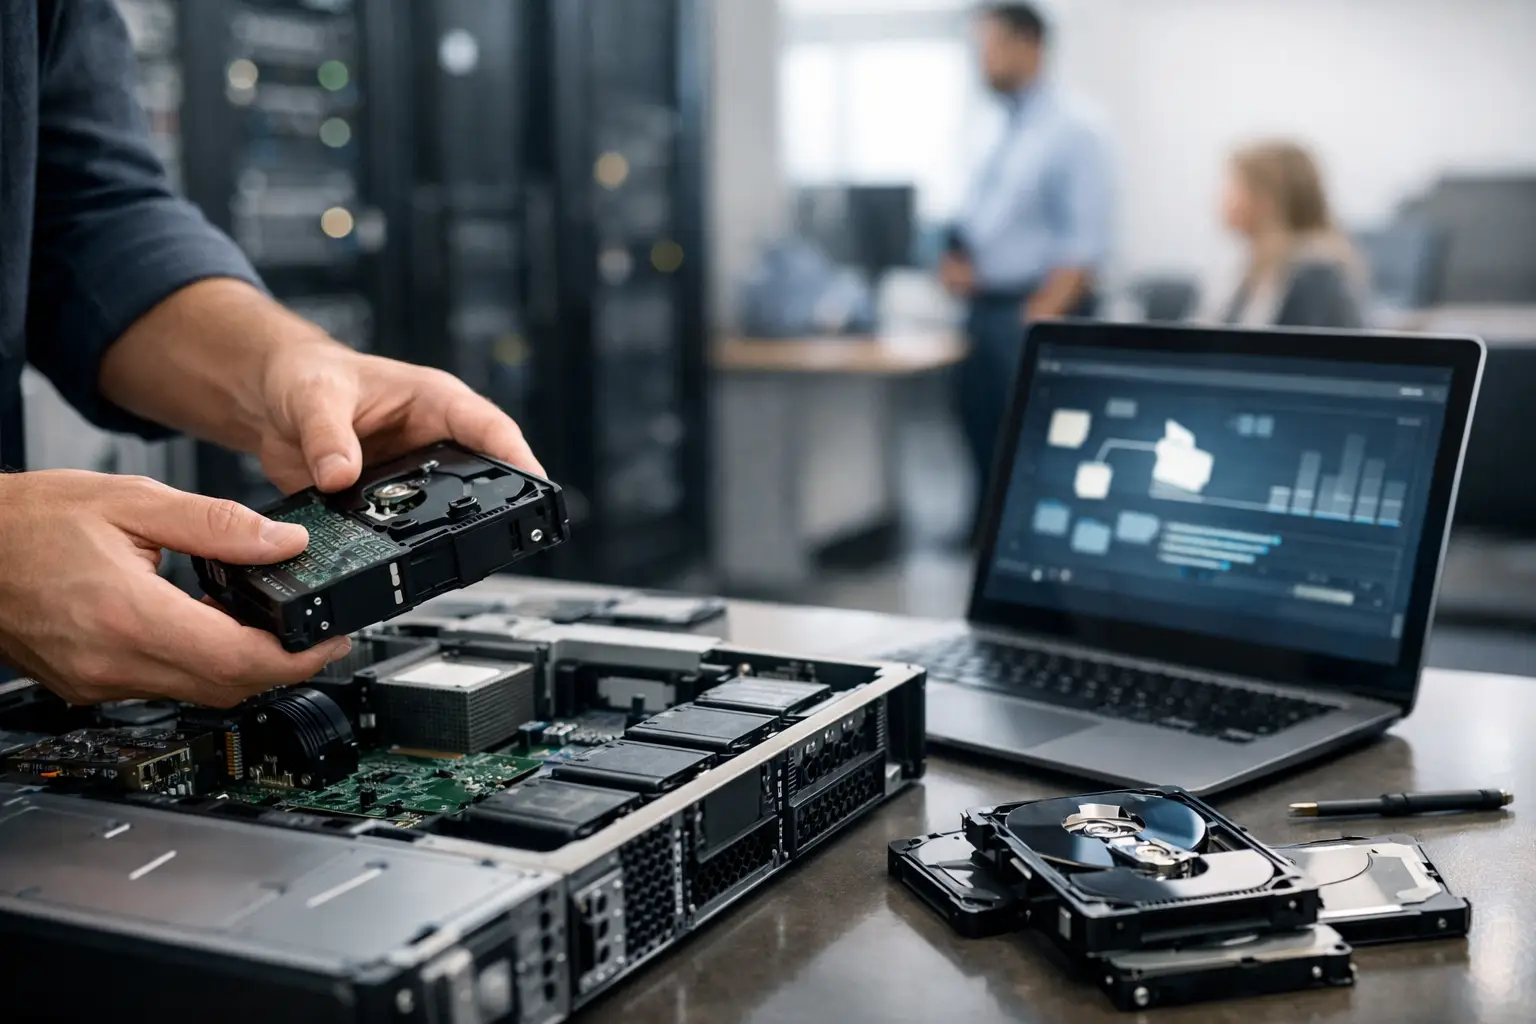
La prima attività è stata quindi isolare la macchina dalla produzione, sospendere i processi che potevano generare nuove scritture e acquisire immagini dei dischi ancora leggibili. Questo passaggio è decisivo. Se si lavora direttamente sui supporti originali, il margine di recupero si riduce.
La diagnosi reale: non tutti i problemi sono uguali
Nel linguaggio comune si dice spesso “si sono rotti i dischi”. In pratica, però, i casi sono diversi. Si può avere un danno fisico al supporto, una corruzione del filesystem, una configurazione RAID incoerente, un controller che scrive metadati errati oppure una combinazione di questi elementi.
Qui il danno era misto. Un SSD aveva settori non più leggibili, il secondo rispondeva in modo intermittente e il controller aveva registrato metadati parzialmente inconsistenti dopo precedenti tentativi di rebuild. Il volume logico era presente, ma la mappa dei blocchi non era più affidabile al 100%.
Questo cambia tutto anche nei tempi. Un guasto lineare ha procedure relativamente rapide. Un danno combinato, invece, obbliga a lavorare per livelli: imaging, ricostruzione virtuale dell’array, verifica delle partizioni, controllo del filesystem e infine recupero dei dati applicativi.
Come si è svolto il recupero
La prima fase ha riguardato la copia bit a bit dei dischi accessibili su supporti di lavoro. Dove la lettura era instabile, si è proceduto con acquisizione progressiva, dando priorità alle aree ancora sane. È una scelta meno spettacolare di un “ripariamo subito”, ma molto più efficace.
Una volta ottenute le immagini, è iniziata la ricostruzione logica del RAID 10. In questa fase il punto critico è identificare correttamente ordine dei dischi, stripe size, offset e stato dei mirror. Un parametro sbagliato può produrre una struttura apparentemente leggibile ma con dati applicativi corrotti.
Dopo la ricostruzione virtuale, il filesystem è risultato montabile solo parzialmente. I file statici del sito erano in gran parte integri, mentre il database mostrava tabelle InnoDB danneggiate e log transazionali incompleti. Qui entra in gioco una distinzione importante: recuperare i file non significa aver recuperato il servizio. Un e-commerce, un gestionale o una piattaforma Moodle possono avere file presenti ma dati applicativi inutilizzabili.
Si è quindi proceduto in parallelo su due binari. Da un lato il recupero dei dump e dei file di configurazione, dall’altro la verifica dei backup gestiti disponibili. Ed è stato proprio il backup a ridurre il danno economico.
Il ruolo del backup: decisivo, ma non magico
L’azienda disponeva di backup incrementali R1Soft con retention di più punti di ripristino. Non erano perfetti: una delle ultime policy aveva tempi anomali e una finestra notturna non completata. Tuttavia esistevano recovery point consistenti fino alla notte precedente per gran parte dei volumi e fino a quattro ore prima per alcuni dataset applicativi.
Questo è il punto che spesso viene capito tardi. Il backup non elimina la necessità del recupero dati, ma può evitare che il recupero dati diventi l’unica strada. Quando il backup è verificato, versionato e separato dalla macchina di produzione, il recovery passa da operazione disperata a procedura controllata.
Nel caso reale, i file recuperati dalle immagini disco sono serviti soprattutto per colmare il delta tra l’ultimo backup integro e il momento del guasto. Database, allegati recenti e alcuni documenti modificati nella prima mattina sono stati ricostruiti incrociando dump, binlog e file recuperati a basso livello.
Il risultato finale è stato un ripristino quasi completo, con perdita limitata a una piccola finestra di transazioni non ancora sincronizzate. Per il business, la differenza è enorme: perdere giorni di dati o perdere pochi minuti non è la stessa storia, né sul piano operativo né su quello reputazionale.
Cosa ha funzionato e cosa no
Ha funzionato la decisione di non insistere con riavvii casuali e rebuild forzati. Ha funzionato la presenza di snapshot e backup incrementali gestiti. Ha funzionato anche la separazione, seppur non perfetta, tra dati statici e dati transazionali, che ha permesso di riportare online prima una parte dei servizi.
Non ha funzionato il monitoraggio preventivo. Gli alert c’erano, ma non sono stati trattati con la priorità corretta. Non ha funzionato neppure la logica “abbiamo il RAID, quindi siamo coperti”. Il RAID migliora continuità e tolleranza al guasto, ma non sostituisce il backup e non protegge da corruzione logica, errore umano o malfunzionamento del controller.
Un altro limite era l’eccessiva concentrazione dei servizi su una sola macchina. Quando database, web server, file share e automazioni interne convivono sullo stesso nodo, anche un singolo guasto storage produce effetti a catena molto più pesanti.
Caso reale recupero dati server: le lezioni operative
Per chi gestisce siti aziendali, e-commerce, CMS o applicazioni interne, il messaggio non è “serve sempre l’infrastruttura più costosa”. Il messaggio corretto è un altro: serve un’architettura coerente con il valore dei dati e con il costo reale del fermo.
Se il progetto genera ordini, lead, documenti o ticket operativi, il backup va pensato come servizio attivo, non come opzione da attivare più avanti. Serve retention su più punti, test di restore periodici e visibilità sugli errori. Lo stesso vale per il monitoraggio dei dischi, degli array RAID e delle latenze storage: gli alert devono arrivare, ma soprattutto devono essere letti e classificati bene.
Ha senso anche distinguere tra ambienti. Un piccolo sito vetrina tollera strategie semplici. Un gestionale, un e-commerce o una piattaforma applicativa richiedono più livelli: backup gestito, storage performante, eventuale replica e, quando il budget lo consente, separazione dei ruoli tra servizi web e database.
Per molte imprese la scelta più efficiente non è gestire tutto in autonomia, ma affidarsi a un provider che unisca server, backup e supporto operativo nello stesso perimetro. È qui che un partner infrastrutturale serio fa la differenza: meno zone grigie, meno rimbalzi di responsabilità, tempi più rapidi quando qualcosa si rompe davvero.
Quanto costa davvero un incidente del genere
La domanda giusta non è solo quanto costa il recupero. Bisogna chiedersi quanto costa l’ora di fermo, quanto vale il dato perso e quanto personale interno viene sottratto ad altre attività mentre si gestisce l’emergenza. In molti casi il costo più alto non è tecnico: è commerciale.
Ordini bloccati, clienti senza accesso, amministrazione ferma, campagne attive che puntano a un sito non disponibile. Se il business dipende dal digitale, il downtime non è un fastidio IT. È una perdita diretta.
Per questo la prevenzione resta l’investimento più conveniente. Storage veloce, backup gestito, controllo dei log, test di ripristino e segmentazione minima dei servizi costano meno di un recovery complesso affrontato sotto pressione.
Un caso reale come questo non serve a fare allarmismo. Serve a ricordare che i dati non si perdono solo per eventi estremi. Più spesso si perdono per piccoli segnali ignorati, processi mai testati e false sicurezze. Quando l’infrastruttura sostiene attività concrete, la domanda da farsi non è se fare backup, ma se saresti davvero in grado di ripartire domani mattina.